알람 규칙 없이 LLM으로 알람 판정하기 - Jev 방식을 exaone으로 흉내 내기
2026-09-27
모니터링 시스템에서 알람 규칙은 보통 SE 등 담당자가 수동으로 설정한다. 예를 들어 CPU > 90%처럼 규칙을 미리 정해 둔다. 빠르지만 규칙을 만든 지표만 잡는다.
새 지표가 생기면 규칙도 새로 만들어야 하고, 평소에도 CPU를 많이 쓰는 서버는 계속 울릴 수 있으며 특수한 상황을 위해서는 비활성화하거나 예외 규칙도 필요하다.
AI가 등장하면서 알람 판정에 LLM을 사용하는 움직임도 활발하다. 지표를 LLM에게 보여 주고 문제 상황인지, 원인은 무엇인지 묻는다. 미리 규칙을 만들어 두지 않아도 되지만 느리고 비싸다. 그런데 요즘 핫한 Jev의 동작 방식을 보니, LLM 판정을 Jev 방식으로 하면 이런 단점을 피할 수 있을 것 같다. (38주차 다이제스트에서도 소개했다.)
Jev는 아직 써 볼 수 없어서, 같은 원리를 로컬 모델(exaone 3.5 2.4B)과 Ollama로 흉내 내서 아래 세 가지 알람 판정 방식을 비교했다.
- 고정 알람 규칙
- LLM 판정(생성 방식)
- LLM 판정(Jev 방식)
생성 방식과 Jev 방식은 같은 모델을 쓴다. 생성 방식은 판정문을 끝까지 쓰게 하고, Jev 방식은 보기 중 하나만 고르게 한다.
Jev는 무엇인가
TypeSafe AI가 공개한 모델로, 분류, 라우팅, 점수화처럼 소프트웨어 안에서 반복되는 판단을 위해 만들었다고 한다. 텍스트를 생성하지 않고 미리 정한 타입의 값과 보정된 확률을 돌려주며 응답 시간은 70~500ms라고 한다. 공개 일주일 만에 개발자 커뮤니티에서 가장 뜨거운 주제가 됐고, 48시간 만에 오픈소스 클론이 6개 넘게 나왔다. 39주차 다이제스트에서 소개한 것처럼, Jev 방식을 스타크래프트 유닛 제어에 붙여 초당 10번씩 움직임을 결정하게 한 사례도 있다.
같은 아이디어를 공개 모델로 흉내 낸 SemIf라는 오픈소스 실험도 있다. 이번 실험도 같은 접근이다.
먼저 알아야 할 것 1: LLM은 답을 한 조각씩 쓴다
ChatGPT나 Claude에 질문하면 답이 한 번에 뜨지 않고 타자를 치듯 조금씩 나타난다. LLM은 답을 한 조각씩, 그러니까 토큰 단위로 쓴다. 한 토큰을 쓰고, 방금 쓴 토큰까지 포함해서 다시 읽고, 다음 한 토큰을 쓴다. 답이 끝날 때까지 이걸 반복한다.
예를 들어 생성 방식으로 어떤 서버의 상태를 판단하게 하면 이런 답이 나온다.
{
  "severity": "주의",
  "cause": "CPU 사용률 급증",
  "reason": "CPU 사용률이 평소 대비 180% 상승하여..."
}
LLM은 이 답을 한 번에 만들지 않고, 대략 이렇게 토큰으로 나눠 하나씩 쓴다.
{ │ " │ sever │ ity │ ": │ " │ 주의 │ ", │ " │ cause │ ... │ }
토큰 하나를 쓸 때마다 계산이 한 번 돈다. 이 판정문은 토큰이 60~100개라서 계산도 60~100번 돌고, 서버 한 대에 2~3초가 걸렸다. 토큰 수는 Ollama가 돌려주는 eval_count 값으로 알 수 있다.
답이 길수록 오래 걸릴 수밖에 없다.
먼저 알아야 할 것 2: “토큰 1개만 쓴다”는 뜻
그렇다면 답을 한 조각으로 만들면 된다.
질문을 객관식으로 바꾸고, 보기 글자 하나로만 답하게 한다.
다음 서버의 상태를 보기에서 골라라.
보기:
A) 정상
B) 주의
C) 장애

서버: game-07 (게임 서버)
- CPU 사용률: 지금 98.3%, 평소 35.0% (+181%)

A, B, C 중 알파벳 한 글자로만 답하라.
이러면 답은 C 한 글자, 즉 토큰 1개다. C는 보기에서 장애를 뜻한다.
여기에 Ollama 옵션으로 한 토큰만 쓰고 멈추도록 지정한다. 생성할 토큰 수의 상한인 num_predict를 1로 주면 된다. 모델이 알아서 짧게 답하길 기대하는 게 아니라, 첫 토큰을 쓰자마자 강제로 멈추게 한다. 그래서 첫 토큰이 반드시 답이 되도록 질문을 만든다.
| LLM 판정(생성 방식) | LLM 판정(Jev 방식) | |
|---|---|---|
| 답 | {"severity": "주의", ... } |
C (장애) |
| 쓰는 토큰 수 | 60~100개 | 1개 |
| 계산 횟수 | 60~100번 | 1번 |
| 서버 한 대 판정 시간(질문 1번 기준) | 2~3초 | 0.2~0.3초 |
Jev 방식의 0.2초는 대부분 질문(서버 설명)을 읽는 시간이다. 질문을 읽는 시간은 두 방식이 같고, 차이는 그 뒤에 토큰을 몇 개 쓰느냐에서 갈린다. 판단이 쉽든 어렵든 토큰 하나를 쓰는 시간은 거의 같다.
먼저 알아야 할 것 3: logprob
토큰을 고르는 순간, LLM 안에서는 모든 후보 토큰에 확률이 매겨진다. 위 질문에 exaone이 첫 토큰을 고를 때 속에서는 이런 표가 만들어진다.
| 후보 토큰 | 뜻 | 확률 |
|---|---|---|
| C | 장애 | 74% |
| B | 주의 | 24% |
** |
보기가 아님 (**C**처럼 굵은 글씨로 답하려는 경우) |
1% |
| A | 정상 | 0.03% |
평소에는 1등인 C(장애)만 출력하고 이 표는 버린다. Ollama에 logprobs: true를 주면 이 표를 함께 돌려준다. 다만 확률을 그대로 주지 않고, 확률에 로그를 씌운 값(logprob)으로 준다.
('C', -0.3), ('B', -1.41), ('**', -4.24), ('A', -7.97)
e^logprob를 계산하면 원래 확률로 돌아온다. C는 e^-0.30 ≈ 0.74, 즉 74%다. 로그를 쓰는 건 아주 작은 확률도 다루기 쉽게 하기 위해서고, 0에 가까울수록 가능성이 높다고 보면 된다.
확률표에는 **처럼 보기가 아닌 후보도 섞여 있다. 그래서 보기 글자의 확률만 남기고, 셋의 합이 100%가 되도록 비율을 다시 계산한다. 위 예시라면 장애 75%, 주의 25%, 정상 0%가 된다.
Jev 방식은 결국 이 세 가지의 조합이다.
- 답을 보기 글자로 정해 두고
- 토큰을 1개만 생성시키고 (
num_predict: 1) - 버려지던 확률표(logprob)에서 보기 글자들의 확률만 읽는다.
한 번의 계산으로 답과 확신도가 함께 나온다. 보기 밖의 답은 나올 수 없으니 파싱 실패도 없다.
왜 exaone + Ollama로 테스트할 수 있나
Jev 방식은 특별한 모델이 아니라 LLM을 쓰는 방법이다. 필요한 조건은 두 가지뿐이다.
- 생성할 토큰 수를 제한할 수 있을 것 (
num_predict) - 토큰을 고를 때의 확률표를 받을 수 있을 것 (
logprobs,top_logprobs)
Ollama의 /api/chat이 둘 다 지원하기 때문에, Ollama로 돌릴 수 있는 모델이면 무엇이든 흉내 낼 수 있다. exaone을 고른 건 이미 로컬에 받아 둔 모델 중 한국어를 가장 잘하는 모델이었기 때문이다. 판정 프롬프트가 한국어라서 중요했다.
실제 요청은 두 방식이 옵션만 다르다.
// LLM 판정(Jev 방식): 토큰 1개 + 확률표
Logprobs:    true,
TopLogprobs: 20,
Options: map[string]any{
	"num_predict": 1, "temperature": 0,
},

// LLM 판정(생성 방식): JSON으로 끝까지
Format: "json",
Options: map[string]any{
	"num_predict": 300, "temperature": 0,
},
물론 진짜 Jev와는 다르다.
| Jev | exaone + Ollama | |
|---|---|---|
| 모델 | 이 용도로 따로 학습한 모델 | 일반 대화용 모델에게 흉내만 내게 함 |
| 확률 | 보정됨. 80%라고 하면 실제로 80% 맞는다(발표 기준) | 보정되지 않음. 99%라고 해도 과신일 수 있음 |
| 알려진 약점 | 사용해 보지 못해 알 수 없음 | 보기를 주는 순서나 프롬프트의 마지막을 어떻게 끝내느냐에 따라 결과가 달라짐 |
exaone + Ollama의 약점은 원래 대화형 LLM을 Jev 방식으로 비정상적(!)으로 쓴 거라 감안해야 한다. 그래서 이번 실험은 Jev 방식의 성능 확인보다는 “보기를 정해 두고 확률을 읽는다”는 아이디어가 기존 알람 판정 방식을 어떻게 바꿀 수 있는지 알아보는 실험에 의의를 둔다.
실험: 서버 21대의 지표를 가정해서 만들기
보려는 건 판정 방식이라 수집 단계는 모두 건너뛰었다. 실제로는 Telegraf 같은 수집기로 모은 지표가 저장소에 쌓이고 거기서 읽어 오겠지만, 판정하는 입장에서는 각 서버의 평소 지표 값과 지금 값만 알면 된다. 그래서 그 값을 코드에서 바로 만들었다.
- 서버: 게임 서버 20대 + 배치 서버 1대
- 지표 6개와 평소 값
| 지표 | 게임 서버 평소 값 | 배치 서버 평소 값 |
|---|---|---|
| CPU 사용률 | 35% | 91% (배치 작업이라 평소에도 높음) |
| 메모리 사용률 | 60% | 70% |
| 요청 에러율 | 0.1% | 0.05% |
| 동시 접속자 | 5,000명 | 0명 |
| 응답시간 p99 | 100ms | 50ms |
| GC 멈춤 시간 | 10ms | 12ms |
지금 값은 평소 값에 ±4% 정도 흔들림을 줬고, 시나리오마다 특정 서버의 특정 지표를 이상한 값으로 바꿨다.
| 시나리오 | 바꾼 값 |
|---|---|
| 평상시 | 없음 |
| 배포 후 전체 에러율 상승 | 게임 서버 20대의 에러율 0.1% → 4% |
| 여러 문제 동시 발생 | game-07 CPU 98%, game-03~05 동접 700명, game-12 GC 450ms·p99 190ms, game-09 메모리 95% |
세 방식은 이렇게 설정했다.
- 고정 알람 규칙: 흔한 규칙 세 개만 뒀다.
CPU > 90%,에러율 > 2%,p99 > 500ms. 메모리, 동접, GC 규칙은 없다. - 생성 방식: 서버 설명을 주고
{"severity", "cause", "reason"}JSON을 끝까지 쓰게 한다. - Jev 방식: 같은 서버 설명을 주고 질문을 두 번 한다. 둘 다 토큰은 1개씩만 만든다.
- 상태: 정상, 주의, 장애 중 하나를 고른다.
- 원인: 1번이 정상이 아니면, 전체 서버 공통 문제(배포 등), CPU 과부하, 메모리 부족, 이 서버만의 에러 증가, 동시 접속자 급감, 응답 지연 또는 GC 멈춤, 알 수 없음 중 하나를 고른다.
생성 방식과 Jev 방식에 주는 서버 설명은 똑같다. 예를 들어 game-07은 이렇게 들어간다.
서버: game-07 (게임 서버)
평소보다 크게 나빠진 지표:
- CPU 사용률: 지금 98.0%, 평소 35.0% (+180%)
그 외 지표는 평소와 비슷하거나 더 좋다.
코드는 Go 파일 하나, 표준 라이브러리만 썼다. 프롬프트를 만들고 요청하는 부분은 앞에서 본 그대로라, 핵심인 확률을 읽는 부분만 옮겨 둔다. resp는 앞의 Jev 방식 옵션으로 Ollama에 요청한 응답이다.
// 확률표에서 보기 글자만 남겨 e^logprob로 확률을 구하고,
// 보기들의 합이 100%가 되도록 비율을 다시 계산
probs := make([]float64, len(options))
var sum float64
for _, t := range resp.Logprobs[0].TopLogprobs {
	tok := strings.TrimSpace(t.Token)
	for i := range options {
		if tok == letters[i] && probs[i] == 0 {
			probs[i] = math.Exp(t.Logprob)
			sum += probs[i]
		}
	}
}
for i := range probs {
	probs[i] /= sum
}
위 코드는 main.go의 choose 함수 일부다. 전체 코드와 실행 방법은 GitHub 저장소에 있다.
실험 결과
평상시
| 서버 | 고정 알람 규칙 | LLM 판정(생성 방식) | LLM 판정(Jev 방식) |
|---|---|---|---|
| batch-01 (평소에도 CPU 91%) | 장애 (오탐) | 정상 | 정상 92% |
| 나머지 20대 | 정상 | 정상 | 정상 |
고정 알람 규칙은 평소 값을 모르니 배치 서버에 대해 알람을 계속 발생시킨다. 생성 방식과 Jev 방식은 평소 값과 비교해서 정상으로 봤다.
배포 후 전체 에러율 상승
| 고정 알람 규칙 | LLM 판정(생성 방식) | LLM 판정(Jev 방식) | |
|---|---|---|---|
| 게임 서버 20대 | 장애 × 20 | 주의 × 20 · “요청 에러율의 급격한 증가로 인한 서비스 불안정성” | 장애 64% · 전체 서버 공통 문제 89% × 20 |
| batch-01 | 장애 (오탐) | 정상 | 정상 92% |
| 알림 수 | 21건 | 20건 | 1건 (20대를 묶음) |
생성 방식도 판정은 맞았지만 원인이 자유 문장이라 “20대가 같은 원인”이라는 걸 코드가 알 수 없다. Jev 방식은 원인이 정해진 보기 중 하나라서 “원인이 전체 공통인 알림이 3대 이상이면 한 건으로 묶는다”를 바로 할 수 있다.
여러 문제 동시 발생
| 서버 | 상황 | 고정 알람 규칙 | LLM 판정(생성 방식) | LLM 판정(Jev 방식) |
|---|---|---|---|---|
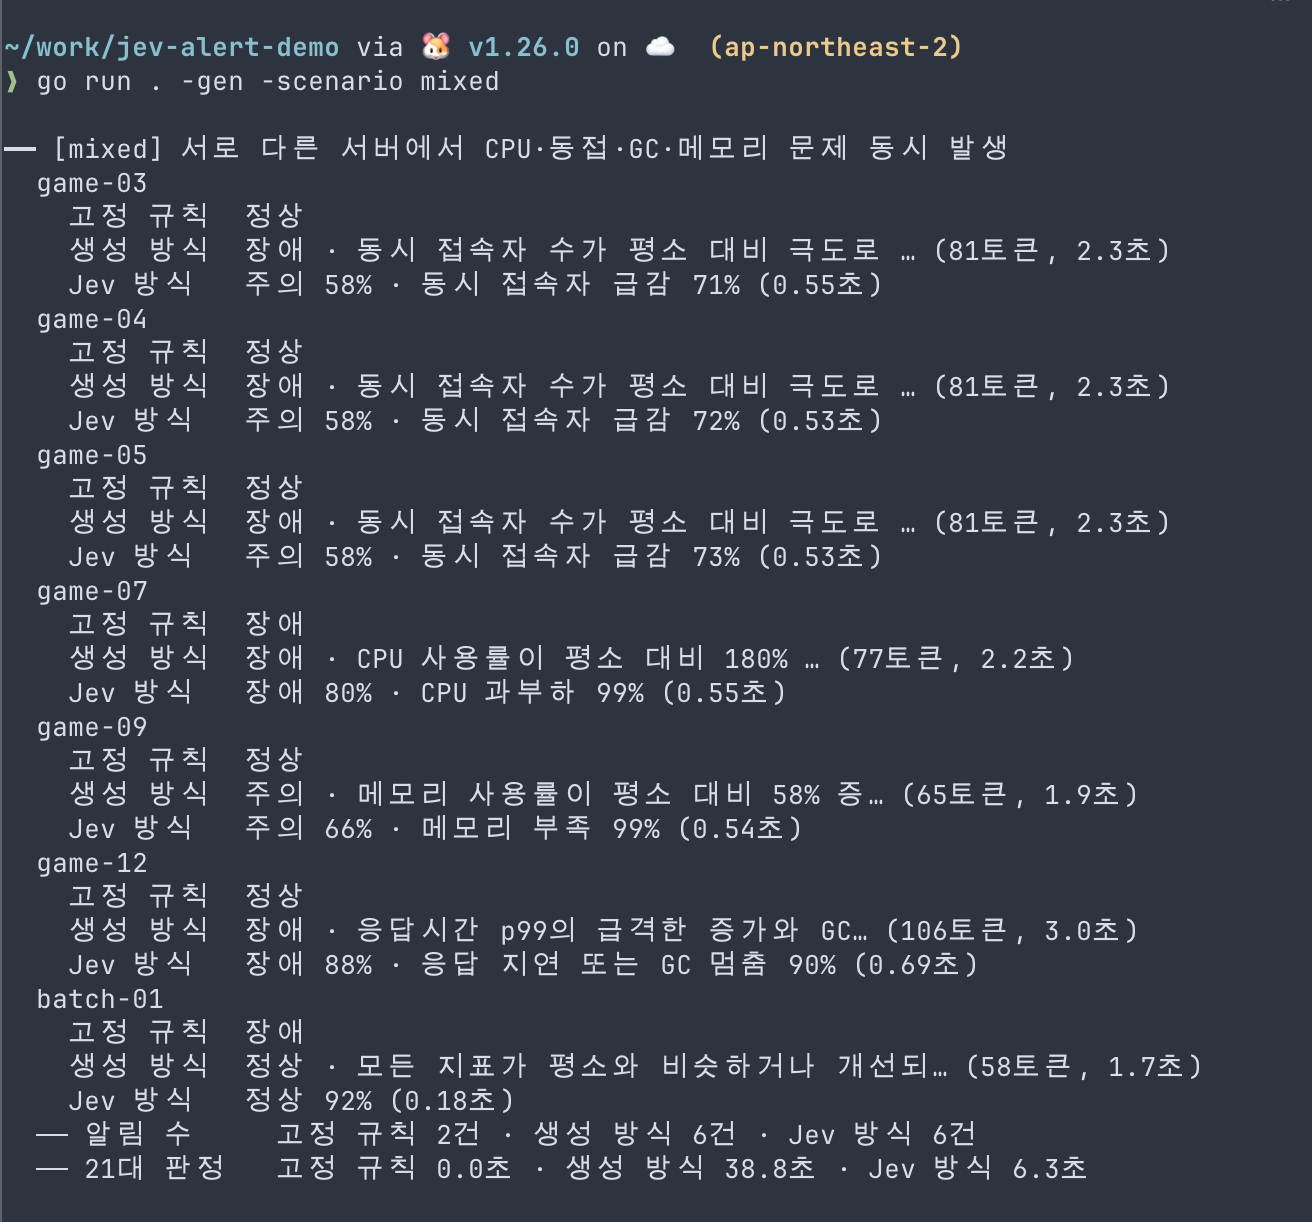
| game-07 | CPU 98% | 장애 | 장애 | 장애 80% · CPU 과부하 99% |
| game-03~05 | 동접 5,000 → 700 | 놓침 | 장애 | 주의 58% · 동시 접속자 급감 72% |
| game-09 | 메모리 95% | 놓침 | 주의 | 주의 66% · 메모리 부족 99% |
| game-12 | GC 450ms, p99 190ms | 놓침 | 장애 | 장애 88% · 응답 지연 또는 GC 멈춤 90% |
| batch-01 | 평소에도 CPU 91% | 장애 (오탐) | 정상 | 정상 92% |
규칙이 없는 동접, 메모리, GC 문제를 생성 방식과 Jev 방식은 모두 잡았다. 판정 결과는 두 방식이 거의 같다.
걸린 시간 (21대 판정)
| 시나리오 | 고정 알람 규칙 | LLM 판정(생성 방식) | LLM 판정(Jev 방식) |
|---|---|---|---|
| 평상시 | 0초 | 40.4초 | 4.0초 |
| 배포 후 전체 에러율 상승 | 0초 | 58.4초 | 17.0초 |
| 여러 문제 동시 발생 | 0초 | 38.8초 | 6.3초 |
생성 방식은 서버 한 대에 판정문 58~106토큰, 1.7~3.5초가 걸렸다. Jev 방식은 정상 서버 0.2초, 이상 서버 0.5~0.8초였다. 이상 서버는 원인을 한 번 더 물어서 두 배쯤 걸린다. 그래서 20대가 전부 이상 상태인 배포 시나리오에서는 Jev 방식도 17초까지 늘었다.
알람 발생기가 15초마다 전체 서버를 한 번씩 판정한다고 하면(판정 주기 15초), 생성 방식은 한 바퀴에 40초에서 1분 가까이 걸려 판정이 계속 밀린다. 그만큼 장애를 늦게 알게 된다. Jev 방식은 대부분 주기 안에 끝난다.
아래는 go run . -gen -scenario mixed로 “여러 문제 동시 발생” 시나리오를 실행한 결과다.
삽질 기록
처음부터 잘 된 건 아니다. 모델보다 입력 설계에서 대부분 시간을 썼다. 어떤 지표가 어느 방향으로 움직여야 문제인지 정하는 데는 모니터링을 해 온 경험이 그대로 쓰였다.
1. 처음에는 모든 서버를 “주의”로 판정했다
지표 6개를 지금 값, 평소 값, 변화율 표로 통째로 줬더니, 2.4B 모델은 멀쩡한 서버까지 전부 “주의 99%”라고 답했다. 토큰 하나를 고르는 한 번의 계산으로 숫자 여러 개를 비교하기엔 벅찼던 것 같다. 그래서 숫자 비교는 코드가 먼저 하고, 평소보다 크게 나빠진 지표만 모델에게 보여 줬다. 모델은 “그게 문제인지, 원인이 뭔지”만 판단한다.
2. 변화율만 보면 노이즈도 이상이 된다
에러율이 0.10%에서 0.15%가 되면 변화율로는 +50%다. 지표마다 최소 변화량(에러율은 0.5%p, 동접은 1,000명 등)을 함께 보게 했다. 또 지표마다 나빠지는 방향을 정했다. 에러율은 오르면, 동접은 내리면 나쁘다. 에러율이 내려가는 건 좋은 소식이라 이상으로 보지 않는다.
3. 다른 서버 소식이 멀쩡한 서버의 판단을 흐렸다
“다른 서버 4대에서 에러율이 올랐다”는 문장을 모든 서버에 보여 줬더니, 정상인 서버도 “주의”로 판정했다. 이 정보는 그 서버도 같은 지표가 나빠졌을 때만 보여 주도록 바꿨다.
4. 프롬프트를 “답:”으로 끝내면 안 된다
답(알파벳 한 글자):로 끝냈더니 모델이 첫 토큰으로 “답”을 따라 썼다. 확률표 상위 후보에 보기 글자가 아예 없었다. “A, B, C 중 알파벳 한 글자로만 답하라.”로 끝내니 첫 토큰이 보기 글자가 됐다. 토큰을 1개만 쓰는 방식에서는 첫 토큰이 곧 답이 되도록 프롬프트를 짜는 게 전부다.
5. 보기 순서가 답을 바꿨다
원인 보기 7개 중 “전체 서버 공통 문제”를 여섯 번째에 두면 배포 시나리오에서 “응답 지연”을 골랐다. 맨 앞으로 옮기니 공통 문제와 개별 문제를 모두 맞혔다. 작은 모델에서 흔한 위치 편향이다.
6. 문구 한두 개가 “정상” 확률을 22%에서 90%까지 바꿨다
같은 정상 서버인데 표현만 바꿔 가며 확률을 재 봤다.
| 질문 끝에 붙인 문장 | 서버 설명 | “정상” 확률 |
|---|---|---|
| 없음 | “모든 지표가 평소와 비슷하다” | 22% |
| 없음 | “모든 지표가 평소와 비슷하거나 더 좋다” | 60% |
| “평소에도 높은 값이면 정상일 수 있다” | “모든 지표가 평소와 비슷하다” | 39% |
| “평소에도 높은 값이면 정상일 수 있다” | “모든 지표가 평소와 비슷하거나 더 좋다” | 90% |
반면 CPU 98% 서버는 어떤 문구에서도 “장애” 91~97%로 흔들리지 않았다. 문구에 민감한 쪽은 분명한 이상이 아니라 “정상”을 판단할 때였다. 확률이 숫자로 나오니 이런 차이를 바로 잴 수 있었다는 점은 오히려 Jev 방식의 장점이기도 하다. 생성 방식이었다면 “정상”이라는 같은 글자 뒤에 이 흔들림이 숨었을 것이다.
결과
- 같은 모델인데 쓰는 방법만 바꿔서 3~10배 빨라졌다. 생성 방식은 서버 21대 판정에 40초 안팎이 걸려 15초 판정 주기를 지킬 수 없었지만, Jev 방식은 대부분 주기 안에 들어왔다. 다만 이상 서버는 원인을 한 번 더 묻기 때문에, 20대가 한꺼번에 이상하면 17초까지 늘었다.
- 속도보다 중요한 건 출력의 형태였다. 답이 정해진 보기 중 하나라서 코드에서 알림을 묶고 담당자에게 보낼 수 있다. 확률도 함께 나오니, 모델이 확신하지 못한 판정(예: 60% 미만)은 바로 알림을 보내지 않고 “확인 필요”로 표시해 사람이 보게 할 수도 있다. 다만 이 확률은 보정되지 않은 값이라, 기준으로 쓰려면 평가 데이터로 먼저 확인해야 한다.
- “평소 값”은 공짜가 아니다. 이번 실험은 평소 값을 정해 두고 시작했지만, 실제로는 최근 기록에서 계산해야 한다. 최근 15분 평균으로 잡으면 방금 끝난 장애 구간이 섞여서, 정상으로 돌아온 걸 오히려 이상으로 보게 된다. 실제 수집 파이프라인에 붙인다면 판정 방식보다 이 부분을 먼저 설계해야 한다.
- 사실 이 정도는 LLM 없이도 된다. 평소 값과 비교하는 일은 이미 코드가 하고 있어서, 원인과 공통 문제 판단까지 if/else로도 가능하다. 고정 알람 규칙이 뒤처지는 건 LLM이 없어서가 아니라 평소 값을 보지 않아서다. Jev 방식이 규칙보다 나을 수 있는 건 에러 로그나 배포 기록처럼 글로 된 맥락을 함께 읽고 판단해야 할 때다. 이번 실험에서는 다루지 않았다.
입력 설계나 평소 값 계산처럼 풀어야 할 문제는 남아 있다. 그래도 로그나 배포 기록 같은 글까지 함께 읽고 빠르고 저렴하게(출력 토큰이 1개뿐이라 유료 API를 써도 비용이 적다) 판정할 수 있다면 의의가 크다. 알람 판정뿐 아니라 분류나 라우팅처럼 LLM으로 반복 판단을 하면서 속도와 비용이 문제였던 다양한 곳에서 Jev 방식을 도입하려는 시도가 활발해질 것 같다.